SEO et GEO
• Structurez des contenus qui répondent aux questions de vos visiteurs : title, titres Hn, maillage interne…
• Rendez-les lisibles par les robots : robots.txt, sitemap, données structurées, llms.txt…
• Gagnez en visibilité, de Google Maps aux réponses de ChatGPT, Perplexity et des AI Overviews.
• Mesurez l'effet de chaque optimisation avec Search Console et Bing Webmaster Tools, et mettez en forme les résultats avec Looker Studio.
Glossaire
Introduction : SEO, GEO et échauffement
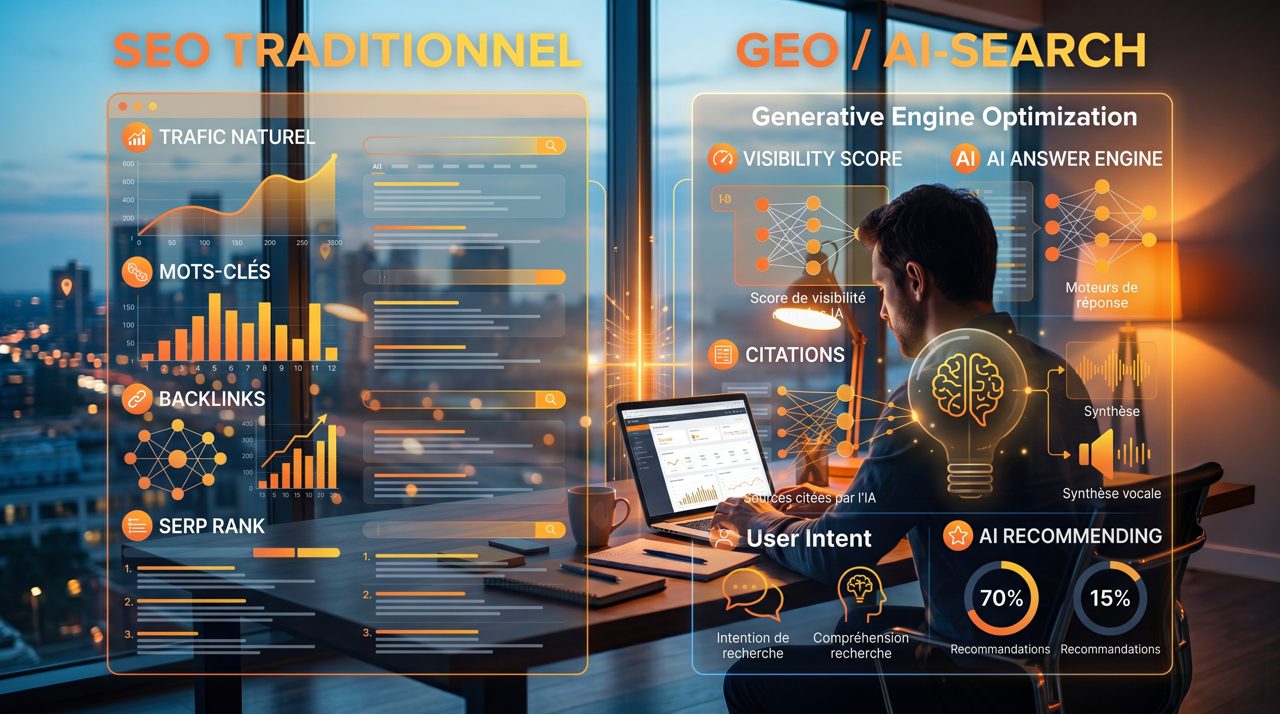
Le SEO vise à être référencé et affiché par un moteur de recherche (Google, Bing, etc.) en réponse à une requête classique. On présente au visiteur un « annuaire », et c'est à lui de choisir en cliquant le site qu'il souhaite visiter.
Le GEO, lui, désigne ce qui est mis en oeuvre pour être cité par les IA (Copilot, ChatGPT, Mistral, Perplexity, ...). L'utilisateur pose sa question en langage naturel, et obtient une réponse du même format, qui synthétise le contenu des sites à partir desquels la réponse a été formulée par l'IA.
En d'autres termes, l'IA dispense l'utilisateur de visiter les sites dont le contenu a servi à construire une réponse. Cette option reste ouverte, mais ne constitue plus un passage obligé.
Ce premier chapitre pose les bases du SEO : comment un moteur explore, indexe et classe vos pages, et ce qu'est la longue traîne.
Quelques analogies en images vous y préparent en douceur.
En quelques mots
Échauffement en images
🧭 Fondamentalement, le SEO, c'est :
Search Engine Optimization : optimiser son site pour être bien positionné dans la SERP (Search Engine Result Page).[1]
On optimise pour un classement.
Pour y arriver, il faut soigner trois aspects :
• savoir de quoi parler (le contenu) ;
• savoir comment en parler (l'expérience, l'expertise, l'autorité et la fiabilité, résumées par le sigle E-E-A-T)[3] ;
• et tout faire pour que ce discours soit facilement détectable et compréhensible, par les humains comme par les robots.
Trois étapes successives inlassablement répétées par les moteurs de recherche[2] :
- L'exploration (crawling) : les robots découvrent les pages en suivant les liens et lisent leur code.
- L'indexation : le moteur analyse chaque page et l'enregistre dans son index.
- Le classement (ranking) : pour chaque requête, il ordonne les pages indexées selon leur pertinence et leur qualité.
📚 L'indexation, expliquée par la bibliothèque du lycée
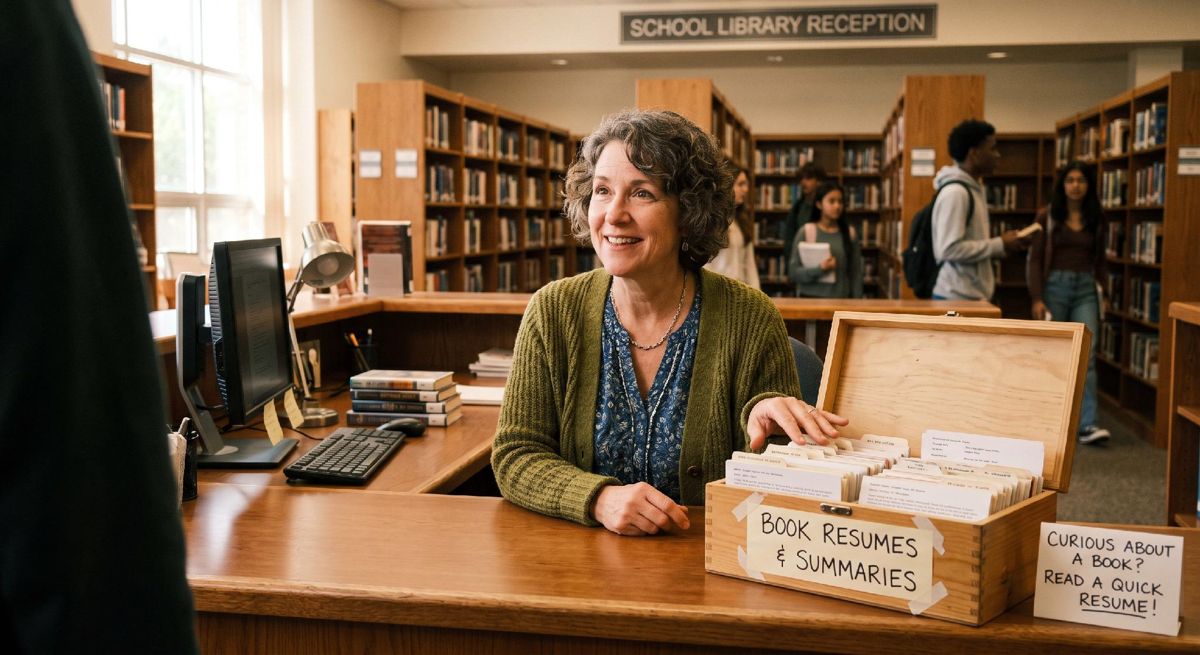
Le web est une immense bibliothèque. Le robot du moteur de recherche en est le documentaliste : il parcourt les rayons (exploration) et rédige, pour chaque livre, une fiche résumé qu'il range dans sa boîte (indexation).
Quand un élève lui demande « un livre sur l'architecture des châteaux forts, au bas Moyen Âge, en Europe », il ne relit pas toute la bibliothèque : il consulte ses fiches et recommande les livres qui répondent le mieux (classement).
Votre title, votre meta description, vos titres H1 et H2 et vos données structurées, c'est le résumé que vous lui rendez facile à écrire. Plus il est clair, mieux votre page est rangée, et plus souvent elle est recommandée.
Et l'IA ? C'est un documentaliste qui, au lieu de tendre trois livres, répond directement à la question… en citant ses sources. C'est tout l'enjeu du GEO.
📸 SEA ou SEO : qui contrôle le message ?
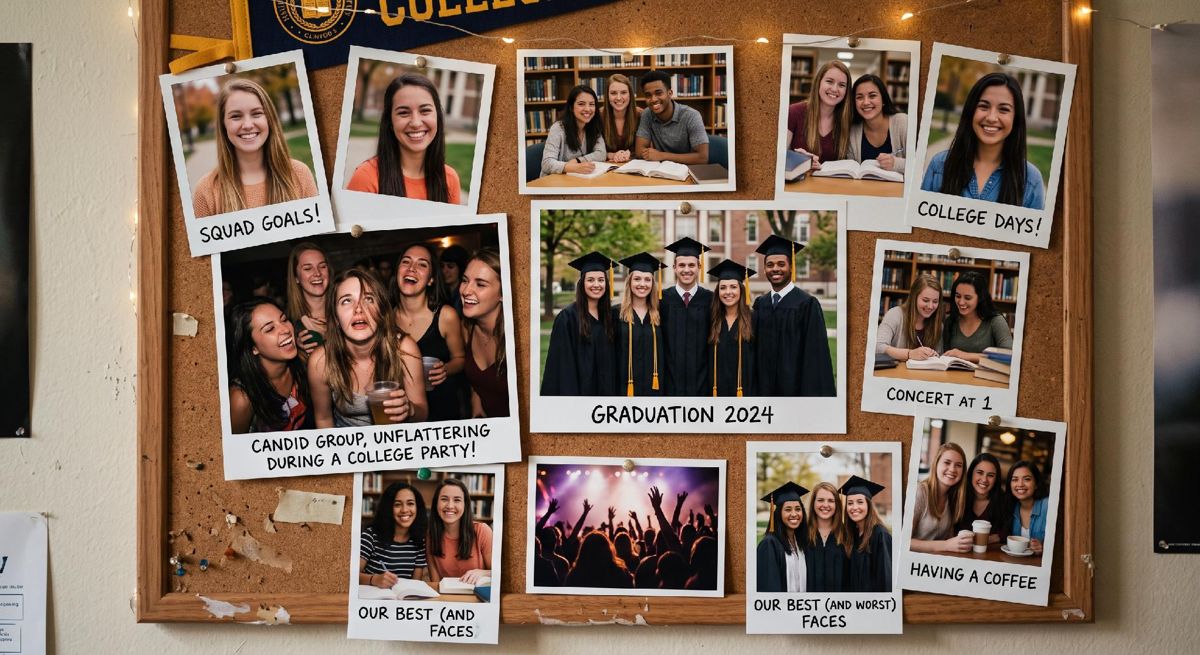
En SEA (les annonces payantes), vous avez la main : vous choisissez la photo affichée, votre message, votre audience. C'est la photo de remise de diplôme.
En SEO, c'est le moteur de recherche qui décide, pas vous. Il pioche dans le tableau et peut afficher la photo de soirée la moins flatteuse : réécrire votre title[4], ou extraire de votre page un passage que vous n'aviez pas prévu de mettre en avant[5].
Vous ne contrôlez pas ce qui sera montré ; vous pouvez seulement faire en sorte que toutes les photos soient bonnes. Chaque page, et même chaque paragraphe, doit pouvoir être affiché seul.
🎯 La longue traîne, expliquée en images
Comment chercheriez-vous ce que montre chaque image ? Faites défiler, puis comparez vos requêtes aux nôtres.
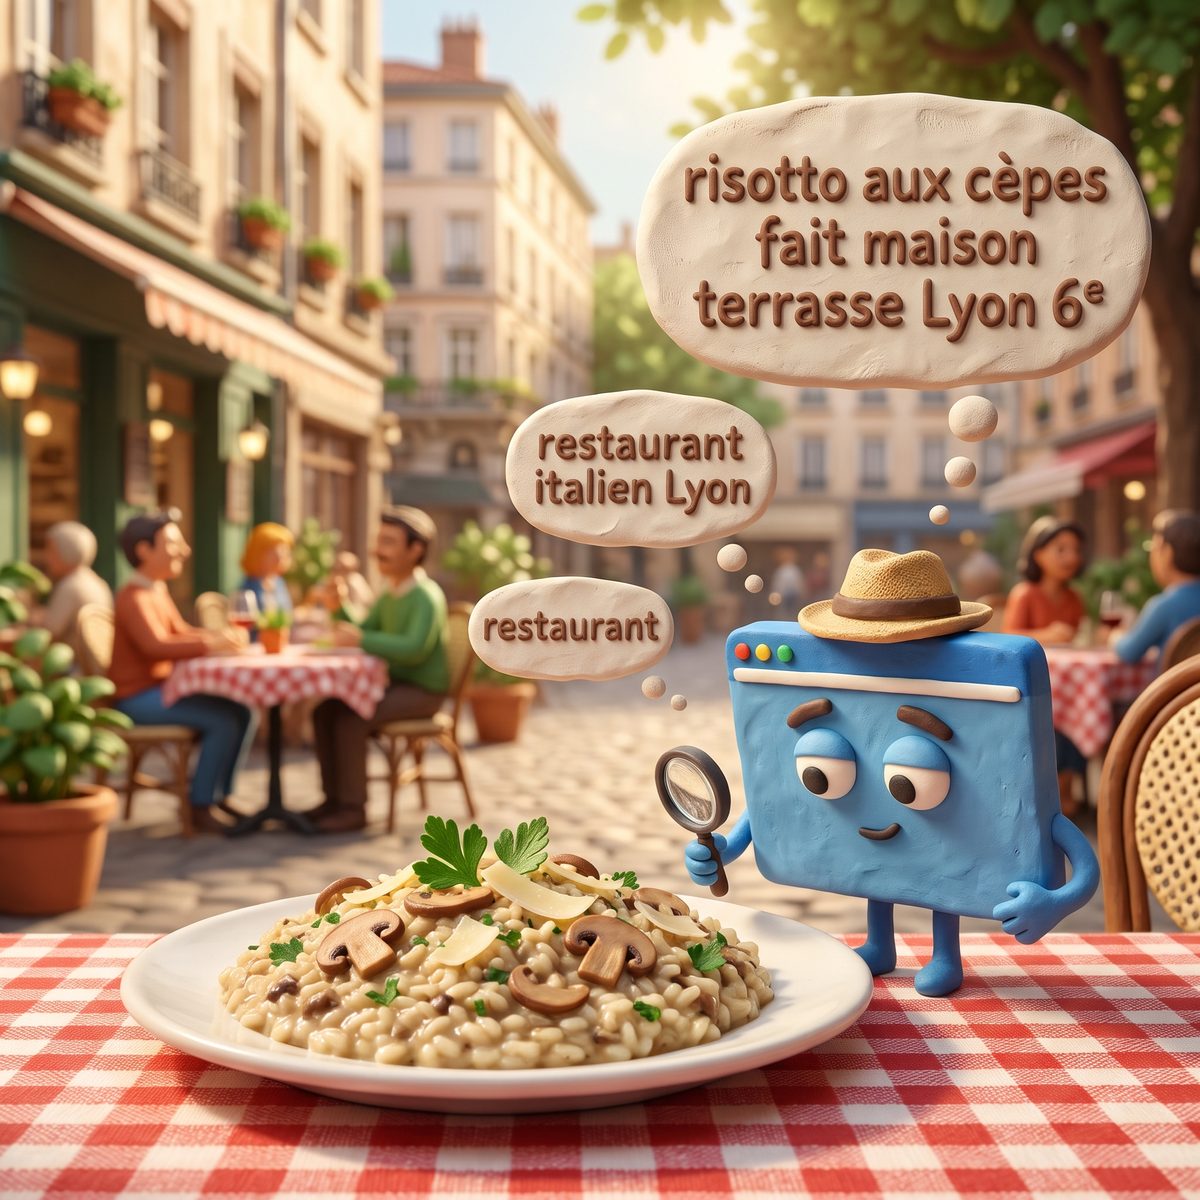
Un produit : un plat au restaurant
« restaurant » → « restaurant italien Lyon » → « risotto aux cèpes fait maison terrasse Lyon 6e ».
La première requête a un énorme volume, mais l'intention est floue et la concurrence maximale. La dernière est rare, mais l'internaute sait exactement ce qu'il veut : il est prêt à réserver.
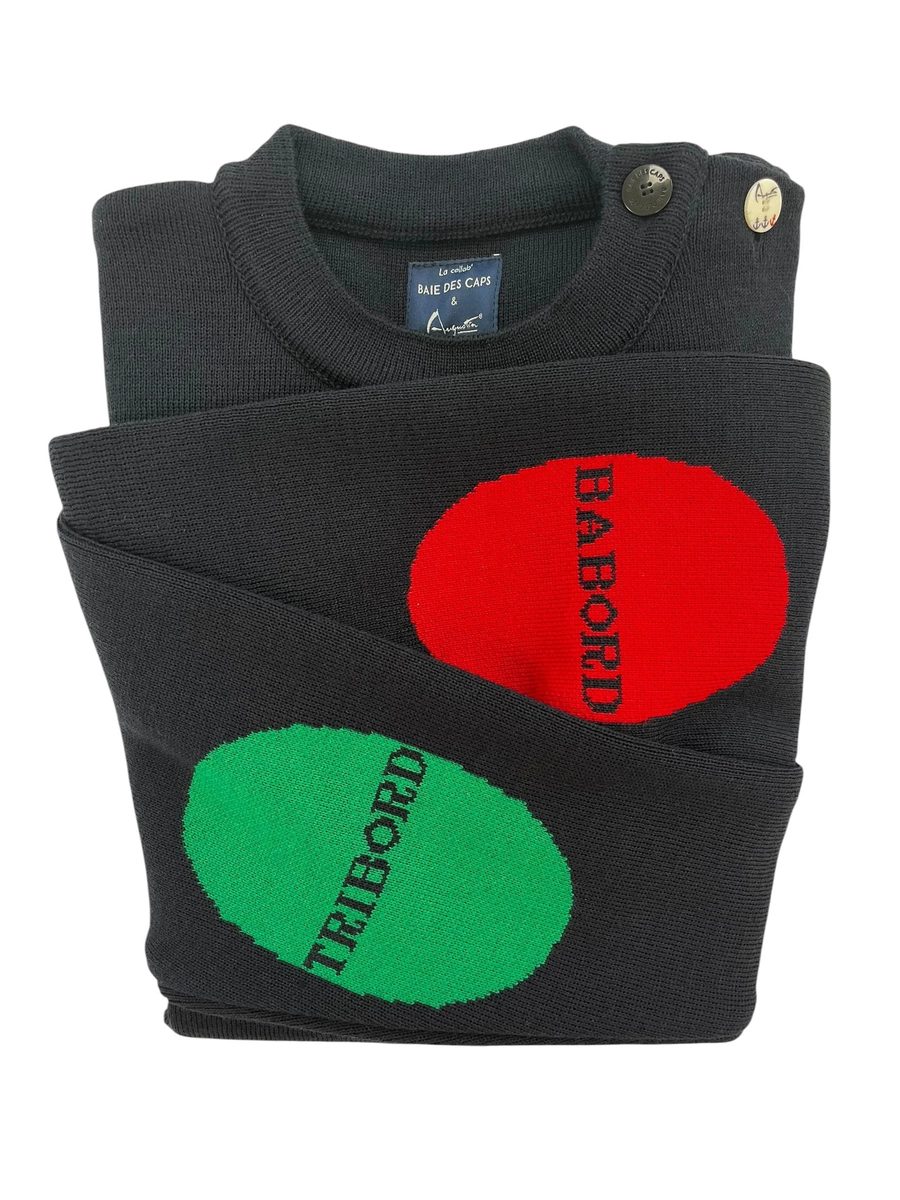
Source : Baie des Caps
Un produit : un vêtement de marque
« pull » → « pull marin homme » → « pull marin homme laine vierge à coudières fabriqué en Bretagne ».
Chaque précision (matière, détail, origine) réduit le volume… et rapproche de l'achat. Et l'internaute qui tape directement « pull Babord Tribord Baie des Caps » sait déjà ce qu'il veut : la requête de marque est la plus précise de toutes.
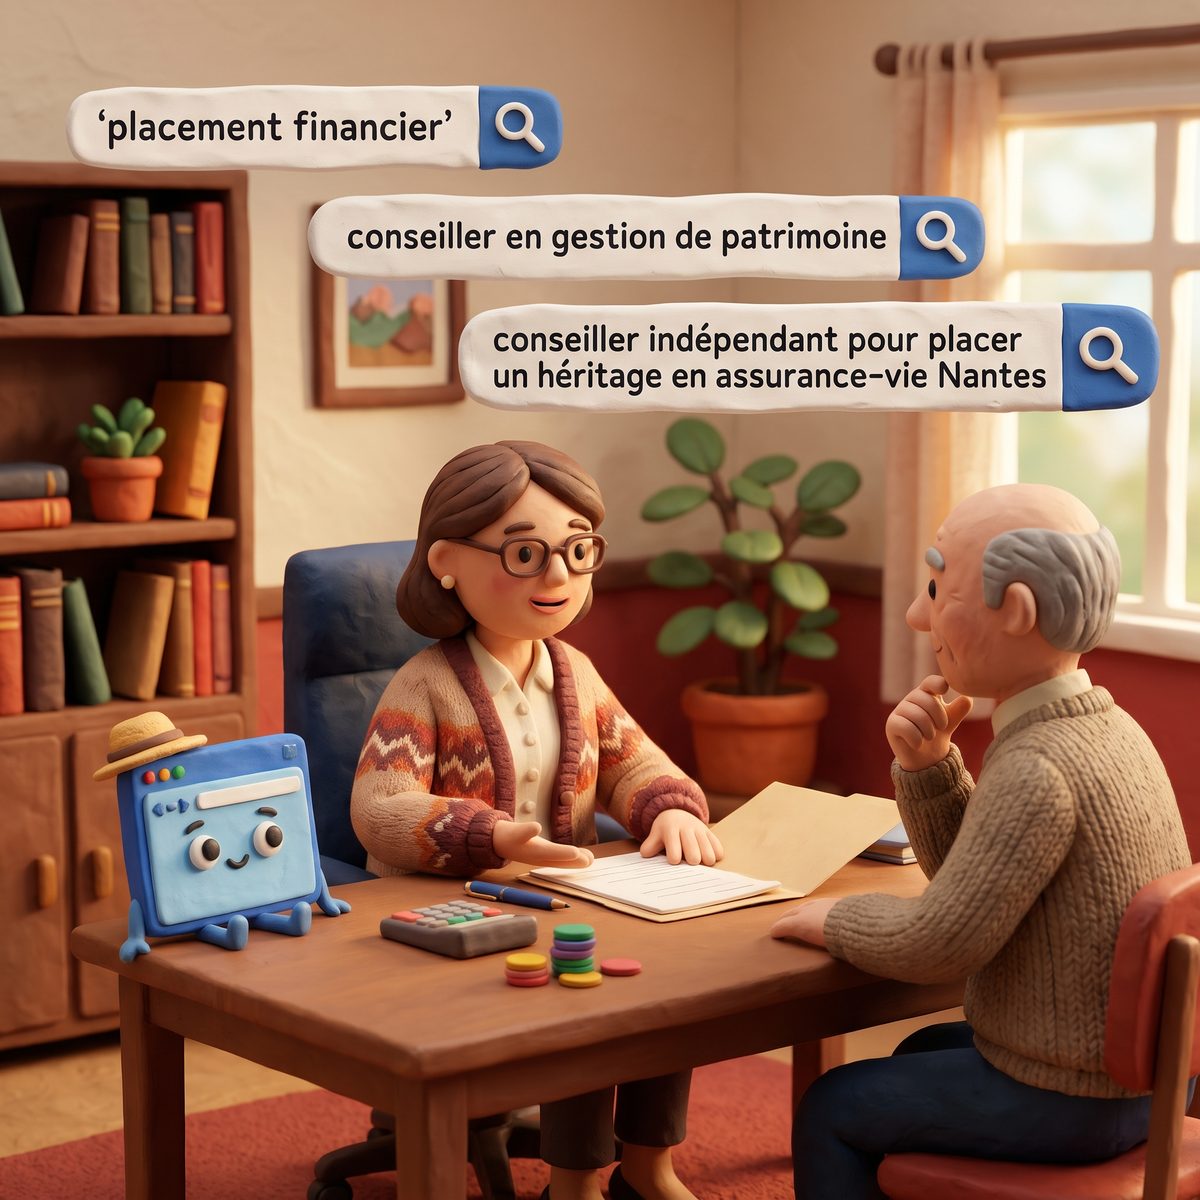
Une prestation : le conseil en placement financier
« placement financier » → « conseiller en gestion de patrimoine » → « conseiller indépendant pour placer un héritage en assurance-vie Nantes ».
Même logique pour un service : la requête longue décrit une situation précise, à laquelle une page dédiée peut répondre mieux que tous les concurrents généralistes.
Chaque requête longue pèse peu, mais leur somme dépasse souvent celle des requêtes courtes, et elles
sont plus faciles à gagner (retour d'expérience).
Avec l'IA, on va plus loin : selon Google, l'AI Mode permet de
poser des questions nuancées, qui auraient auparavant demandé plusieurs recherches, et d'obtenir une réponse
accompagnée de liens vers les sites sources[6].
GEO (Generative Engine Optimization)
L'objectif : être cité comme source dans une réponse rédigée par une IA (ChatGPT, Perplexity, Google AI Overviews)[7].
On optimise pour être l'extrait que le modèle reprend.
📖 Le saviez-vous ? SEO et GEO reposent sur les mêmes fondamentaux
Un site explorable, un contenu clair, des données structurées. Bien faire son SEO technique, c'est déjà l'essentiel du GEO[6].
Ressources utiles
📌 Pour découvrir le référencement naturel
📌 Pour comprendre les fonctionnalités IA des moteurs
📌 Usage des moteurs de recherche et navigateurs par continents
Exercices pratiques
Quiz
Structure, contenu et on-page
Le premier chapitre a posé trois exigences : savoir de quoi parler, savoir comment en parler, et rendre ce discours facile à trouver. Ce chapitre traite les deux premières, page par page. Title, meta description, titres Hn, maillage interne : il montre comment structurer une page pour qu'elle réponde clairement à une intention de recherche, sans concurrencer ses voisines. Il aborde aussi les critères de qualité E-E-A-T, qui comptent pour Google. La troisième exigence, rendre ce contenu lisible par les robots, fait l'objet du chapitre suivant.
Petit échauffement en image
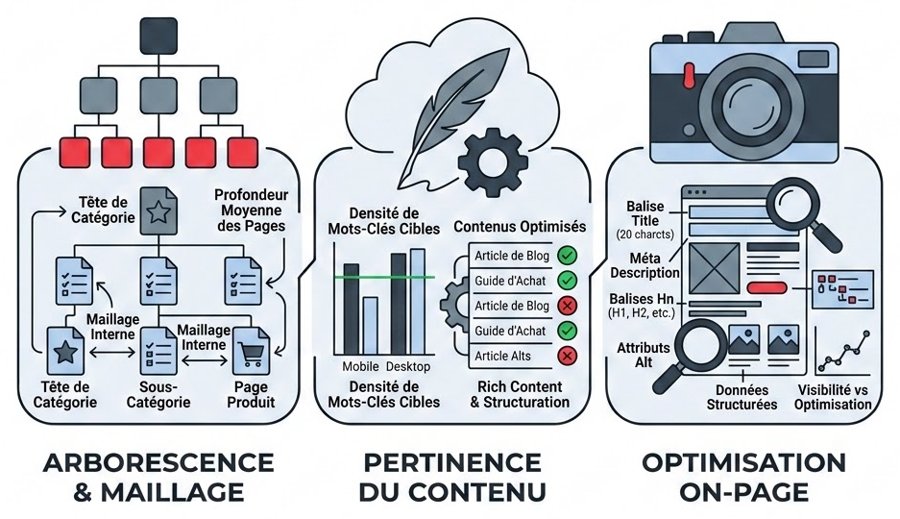
Qu'est-ce qui vous parle dans cette illustration ?
- Comment un internaute, et un robot, passent-ils d'une page à l'autre d'un site ?
- Selon vous, qu'est-ce qu'un contenu « pertinent » ?
- Quelles balises d'une page connaissez-vous ? À quoi servent-elles ?
En quelques mots
Un audit on-page tient en trois réflexes : view-source: devant l'adresse de la page (le code source, ce que reçoit le robot), puis
l'inspecteur du navigateur, clic droit → « Inspecter », onglet « Elements » ou « Inspecteur » (la page après
exécution du JavaScript, ce que voit l'utilisateur), un validateur (ce que comprend la machine).
Title et meta description
Ensemble, ils forment le « pitch » de la page dans les résultats[1][2]. Le title n'a pas de limite de longueur, mais Google le tronque au besoin, en général pour l'adapter à la largeur de l'écran, et peut le réécrire. Il conseille d'éviter les titles inutilement longs[1].
Les balises Hn
Elles organisent la page : un H1 unique[4] pour la requête principale, des H2 pour les requêtes secondaires (les questions des internautes), des H3 pour la longue traîne. Plus on descend, plus la concurrence baisse et plus l'intention est précise : c'est aussi ce dont se nourrissent les IA (retour d'expérience).
Maillage interne et cannibalisation
Les liens entre pages font circuler la popularité vers les pages stratégiques[8]. Deux pages qui visent la même requête se font concurrence (cannibalisation) : Google hésite entre elles et répartit les signaux (liens, clics), si bien qu'aucune ne s'impose (retour d'expérience). Trois remèdes selon le cas. Fusionner quand les pages répondent à la même intention : on garde la plus forte, on y reprend le contenu utile des autres et on redirige les anciennes adresses en 301[10]. Différencier quand chaque page a sa raison d'être : on réécrit title, H1 et contenu pour que chacune vise une intention distincte. La balise canonical, seulement quand les pages sont quasi identiques mais doivent rester accessibles (variantes de couleur, paramètres de tri ou de suivi) : elle désigne la version à indexer[9].
Attribut alt et Open Graph
Le texte alternatif décrit l'image
(accessibilité, Google Images)[5] ; les balises Open Graph définissent l'aperçu lors d'un partage sur les
réseaux[6]. Elles ne figurent pas parmi les balises meta prises en charge par Google[3], qui peut
toutefois lire og:title pour composer le titre affiché dans ses résultats[1] et
og:image pour choisir l'image d'une page[5]. Aucune page de Google n'en fait un critère de
classement. Leur intérêt est ailleurs : un aperçu soigné (titre, image, description) quand la page est partagée sur LinkedIn, WhatsApp ou Slack donne envie de cliquer et de repartager. Plus de visites, plus de mentions, parfois des liens : c'est en ce sens que l'intérêt SEO est « indirect ». Comme elles ne coûtent presque rien, on les génère automatiquement sur toutes les pages, via le gabarit du site.
E-E-A-T : Expérience, Expertise, Autorité, Fiabilité
Ce sont les critères de qualité d'un contenu pour Google. L'E-E-A-T n'est pas en soi un facteur de classement, précise Google : ses systèmes s'appuient plutôt sur un ensemble de signaux qui permettent de repérer un contenu qui en fait preuve[7]. La fiabilité en est le socle[7] : identité claire, informations exactes, site sécurisé. Les guides et tutoriels démontrent l'expertise et captent les recherches en amont de l'achat (retour d'expérience).
📖 Le saviez-vous ? Les titres génériques ne disent rien
Un H2 « Table des matières » ou un H3 « Ressources utiles » répété dans chaque section n'apprend rien au moteur sur le sujet de la page. Un bon titre reprend une question réelle de l'internaute ou un aspect précis du sujet. L'exercice sur la structure Hn le montre… sur les pages de ce site.
Ressources utiles
📌 Pour optimiser les balises de la page
📌 Pour produire un contenu de qualité
Exercices pratiques
Quiz
SEO technique et indexation
Un excellent contenu ne sert à rien si les robots ne peuvent pas le lire. Ce chapitre passe en revue tout ce qui se joue avant le classement : robots.txt et sitemap, accès des robots d'IA, canonical et redirections, données structurées et expérience sur la page. Un cas vécu sur ce site montre qu'une page bloquée peut tout de même rester indexée.
Petit échauffement en image
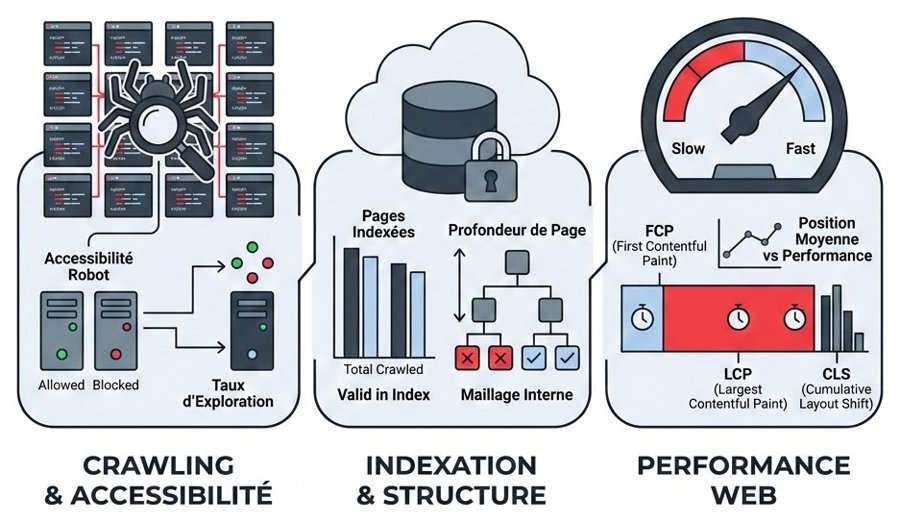
Qu'est-ce qui vous parle dans cette illustration ?
- Qu'est-ce qui peut empêcher un robot d'accéder à une page ?
- Une page explorée par Google est-elle forcément indexée ?
- Quels indicateurs de vitesse d'une page connaissez-vous ?
En quelques mots
Le robots.txt
C'est le panneau d'accueil que tout robot lit en premier. Il indique ce qu'un moteur a le droit d'explorer[1] : on y bloque typiquement les facettes et les tris[9][10],
le tunnel d'achat et l'espace client. Attention : Disallow empêche l'exploration, pas
l'indexation. Pour retirer une page de l'index, il faut une balise noindex, sur une page restée explorable[8].
Une page bloquée peut même apparaître dans les résultats, sans description, si d'autres sites pointent vers elle[1].
Deux caractères à connaître : * remplace n'importe quelle suite de caractères, $ marque
la fin de l'URL[2][3]. Ainsi, Disallow: /*training_material*.pdf$, la règle de ce site, bloque toute URL
qui contient « training_material » et se termine par « .pdf ».
Le budget d'exploration
C'est le temps qu'un robot accepte de
passer sur un site[9]. Le sitemap (avec la date de mise à jour <lastmod>) l'oriente vers les
pages prioritaires[5][6] ; le robots.txt l'éloigne des doublons[9]. Un sitemap contient au maximum 50 000 URL
(50 Mo non compressé) ; au-delà, on le découpe en plusieurs fichiers, réunis par un index de sitemaps[6][7].
Les robots d'IA
GPTBot[14], ClaudeBot[15] ou PerplexityBot[16] héritent de la règle User-agent: * s'ils ne sont pas nommés[3]. Les autoriser ou les bloquer
est un arbitrage business, à décider robot par robot. Cas particulier : Google-Extended n'est pas
un robot mais un jeton ; le bloquer refuse que le contenu serve à entraîner et alimenter Gemini, sans aucun effet
sur la recherche Google[13]. Et autoriser un robot ne garantit pas qu'il passe : un pare-feu (WAF) peut le bloquer
quand même. Pour le vérifier, on interroge le site en se faisant passer pour le robot (exercice « Le site
laisse-t-il entrer les robots ? ») : un code 403[17] signale qu'une protection le bloque, malgré
l'autorisation du robots.txt.
La balise canonical
Elle désigne l'URL de référence quand plusieurs URL affichent le même contenu (filtres, paramètres, pages par magasin) : les signaux sont regroupés au lieu d'être dilués[11].
Redirections 301 et erreurs 404
Quand un produit disparaît ou change d'URL, une redirection permanente (301) vers la nouvelle page indique à Google que la nouvelle adresse devient l'adresse de référence[12], et évite d'envoyer l'internaute sur une page d'erreur.
Les données structurées (JSON-LD Schema.org)
Elles décrivent explicitement
le contenu aux machines : Product, Offer, BreadcrumbList, Article…[18]
Elles rendent la page éligible aux résultats enrichis (prix, stock, étoiles)[18]. Pour ses fonctionnalités
d'IA, Google précise qu'elles ne sont pas indispensables et qu'aucun balisage spécial n'est nécessaire, mais il
conseille de continuer à les utiliser[23].
Deux règles. Le balisage doit décrire ce qui est visible sur la page, sinon celle-ci perd son
éligibilité[19]. Dans le Test des résultats enrichis, une erreur rend la page inéligible ; un
avertissement signale un champ recommandé manquant[19]. Sur une fiche produit, deux exemples courants.
Les étoiles : elles s'appuient sur la propriété aggregateRating, qui doit contenir au
minimum la note moyenne (ratingValue) et le nombre d'avis (reviewCount)[21].
La disponibilité : le statut « en stock » se déclare avec availability, à l'intérieur
de l'offre du produit (offers)[22].
Les Core Web Vitals
Ils mesurent l'expérience sur la page : LCP (chargement, bon à 2,5 s ou moins), INP (réactivité, 200 ms ou moins) et CLS (stabilité visuelle, score de 0,1 ou moins)[26].
📖 Le saviez-vous ? Google tolère certaines coquilles… pas toutes
L'analyseur de robots.txt de Google comprend Dissalow: ou Disalow: comme
Disallow:[4]. Mais il ne tolère pas toutes les fautes, et rien n'oblige les autres
robots à en faire autant. Un robots.txt édité à la main finit toujours par contenir une erreur : relisez-le
régulièrement.
🔍 Cas vécu sur ce site : une préprod protégée… et pourtant indexée dans Bing
La version de travail de ce site, preprod.formation.dibenn.com, est protégée par trois verrous :
Disallow: / dans le robots.txt, l'en-tête X-Robots-Tag: noindex et la balise meta
noindex. Pourtant, Bing la garde dans son index depuis le 6 août 2025.
1. Le constat. Dans Bing Webmaster Tools (présenté au chapitre Indicateurs), le Site Explorer l'affiche comme « Indexed », sans impression ni clic.
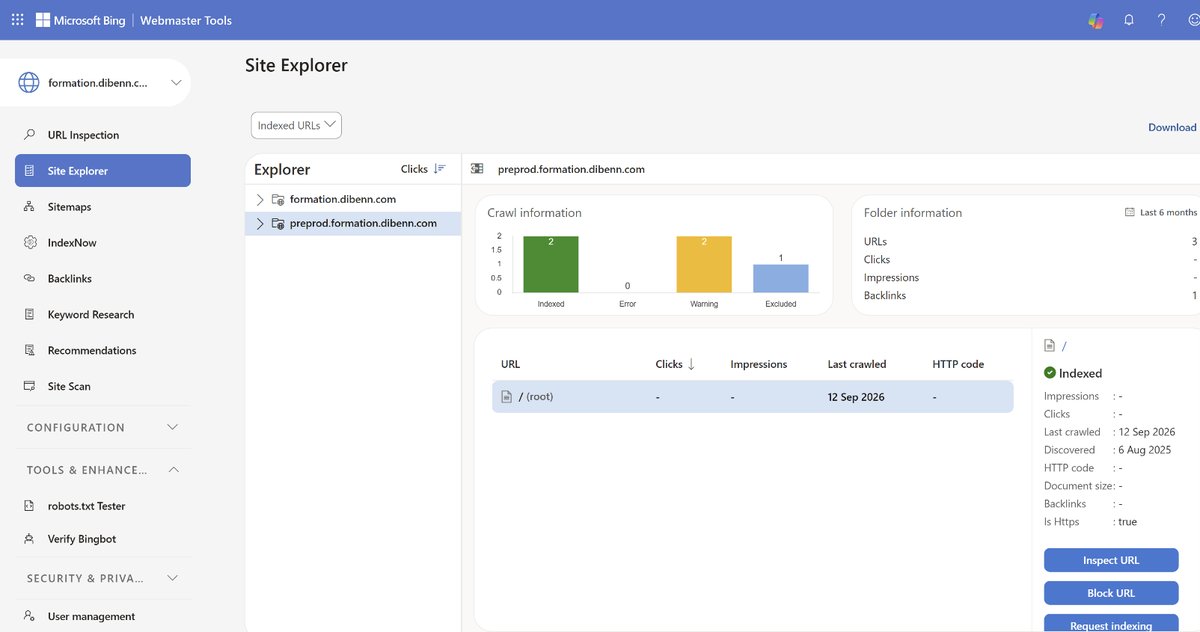
2. Le diagnostic. L'outil URL Inspection donne l'explication :
« Indexed but blocked by robots.txt ». Bing n'a pas le droit d'explorer la page (« Crawl allowed? No ») et
n'a pas pu la récupérer (« Page Fetch : Failed »). Mais rien ne lui interdit de l'indexer (« Indexing
allowed? Yes ») : il ne voit pas le noindex, puisqu'il ne peut pas lire la page. Il l'a donc
indexée à partir de sa seule adresse. Bing le dit lui-même dans l'encadré rouge.
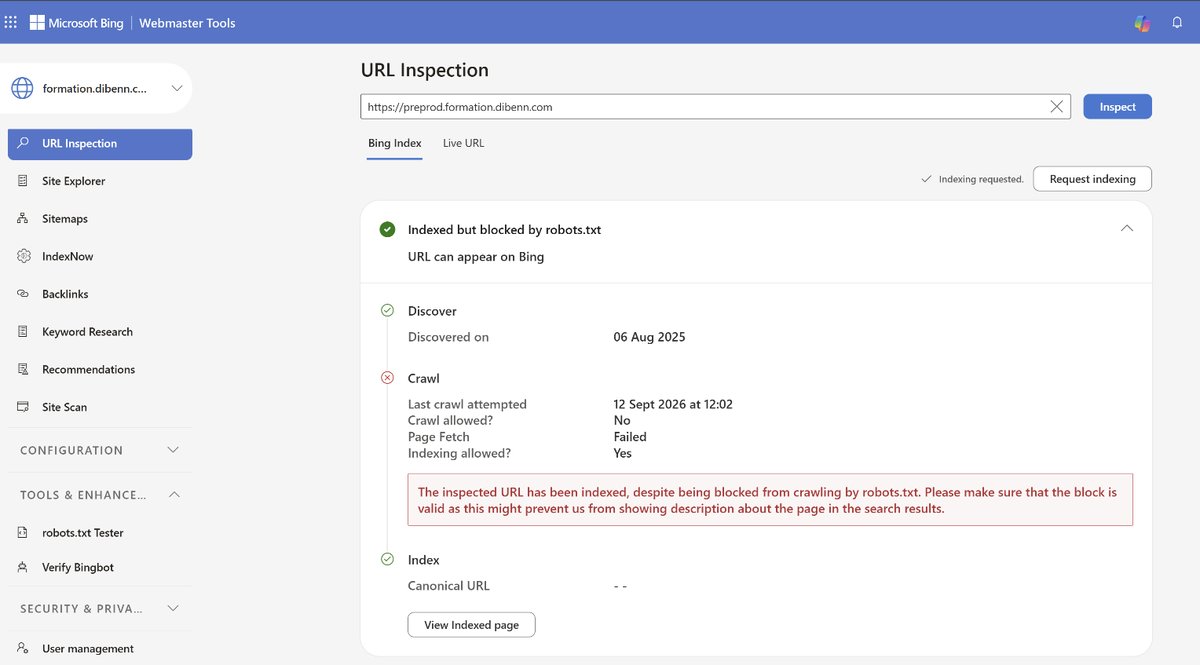
C'est la règle vue plus haut : Disallow empêche l'exploration, pas l'indexation[1]. Et une page
bloquée ne peut pas transmettre son noindex.
3. Le remède appliqué ici.
-
Ouvrir temporairement le robots.txt au seul robot de Bing, en laissant tous les autres
bloqués, robots d'IA compris :
User-agent: bingbot
Allow: /

User-agent: *
Disallow: /
-
Dans URL Inspection, cliquer sur Request indexing : « Indexing requested » s'affiche à
côté du bouton. Le nom du bouton est trompeur : il déclenche simplement une visite, au cours de laquelle
Bingbot lira le
noindex. - Quelques jours plus tard, vérifier dans URL Inspection que la page est sortie de l'index, puis remettre le blocage complet.
Le bouton Block URL permet aussi de masquer rapidement une adresse dans Bing.
À retenir : pour une préprod, la protection la plus solide reste un mot de passe côté serveur (code 401)[1]. Aucun robot ne voit alors le contenu, et la question ne se pose plus.
Ressources utiles
📌 Pour maîtriser l'exploration et l'indexation
- [1] Présentation du fichier robots.txt — Google
- [2] Comment Google interprète le robots.txt (syntaxe, * et $) — Google
- [3] RFC 9309 : la norme du robots.txt (IETF, en anglais)
- [4] Le code de l'analyseur robots.txt de Google, qui tolère certaines coquilles (GitHub, en anglais)
- [5] Présentation des sitemaps — Google
- [6] Créer et envoyer un sitemap (50 000 URL, 50 Mo) — Google
- [7] Gérer les sitemaps volumineux (index de sitemaps) — Google
- [8] Bloquer l'indexation avec noindex — Google
- [9] Gérer le budget d'exploration — Google
- [10] Gérer l'exploration de la navigation à facettes — Google
- [11] Spécifier une URL canonique — Google
- [12] Redirections et recherche Google
📌 Pour identifier les robots d'IA
📌 Pour baliser et tester ses données structurées
- [18] Introduction aux données structurées — Google
- [19] Consignes générales sur les données structurées — Google
- [20] Données structurées Product — Google
- [21] Données structurées des extraits d'avis (étoiles) — Google
- [22] Données structurées des fiches marchandes (prix, disponibilité) — Google
- [23] Recherche générative de Google : les bonnes pratiques (en anglais)
- [24] Test des résultats enrichis — Google
- [25] Schema Markup Validator
📌 Pour mesurer la performance des pages
Exercices pratiques
Quiz
SEO local, off-page et outils tiers
Votre visibilité ne se joue pas seulement sur votre site. Ce chapitre explore tout ce qui l'entoure : la fiche Google Business Profile pour les recherches locales, les backlinks qui traduisent la confiance des autres sites, Google Merchant Center pour les catalogues, et les outils qui relient le trafic naturel au chiffre d'affaires. Sans oublier d'observer ce que font les concurrents.
Petit échauffement en image
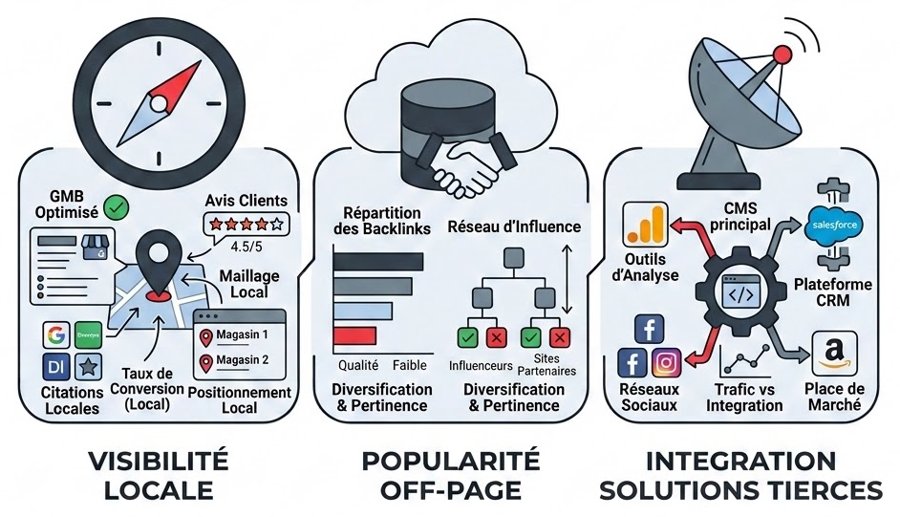
Qu'est-ce qui vous parle dans cette illustration ?
- Qu'est-ce qui fait qu'un magasin apparaît dans Google Maps ?
- Pourquoi un lien venant d'un autre site compterait-il pour Google ?
- Quels outils ou plateformes externes contribuent à votre visibilité ?
En quelques mots
Le SEO local
Il vise les recherches à intention géographique (« magasin de bricolage près de chez moi »). La fiche Google Business Profile de chaque établissement (horaires, avis, photos) alimente Google Maps et le pack local, et génère des visites en magasin (retour d'expérience). Google classe les résultats locaux selon trois critères : la pertinence de la fiche, la distance avec l'internaute et la notoriété de l'établissement (avis, liens, présence en ligne). La publicité n'y change rien[1].
Les backlinks
Ce sont les liens d'autres sites vers le vôtre : des votes de confiance qui transmettent popularité et autorité[4]. Le netlinking consiste à en obtenir de qualité (presse, partenaires, contenus de référence). Les liens achetés ou échangés en masse enfreignent les règles de Google[3]. Le rapport Liens de Search Console (présentée au chapitre Indicateurs) liste gratuitement les sites qui pointent vers le vôtre[2].
Google Merchant Center
Il reçoit le flux catalogue d'un site marchand (prix, stocks, caractéristiques) et alimente Google Shopping et les fiches produits gratuites[6].
Les outils de mesure d'audience
GA4, Piano Analytics et leurs équivalents relient le trafic naturel aux parcours et au chiffre d'affaires : c'est ce qui permet de mesurer la contribution réelle du SEO.
Le benchmark concurrentiel
Pour une requête cible, comparez ce que les concurrents affichent dans les résultats (title, meta description, étoiles), et vérifiez s'ils sont cités dans les réponses des IA.
📖 Le saviez-vous ? Vos réseaux sociaux dans Search Console
Search Console permet désormais de rattacher à sa propriété ses chaînes vidéo et comptes de réseaux sociaux, pour suivre leur visibilité dans la recherche Google aux côtés du site[5].
🔍 Pourquoi les backlinks diffèrent entre Bing et Google
Ce sont deux robots, deux index et deux manières de trier :
- chaque moteur ne montre que les liens qu'il a lui-même trouvés et retenus ;
- Search Console n'en affiche qu'un échantillon, et en omet certains (pages non indexées, doublons)[2] ;
- Bing filtre moins (retour d'expérience).
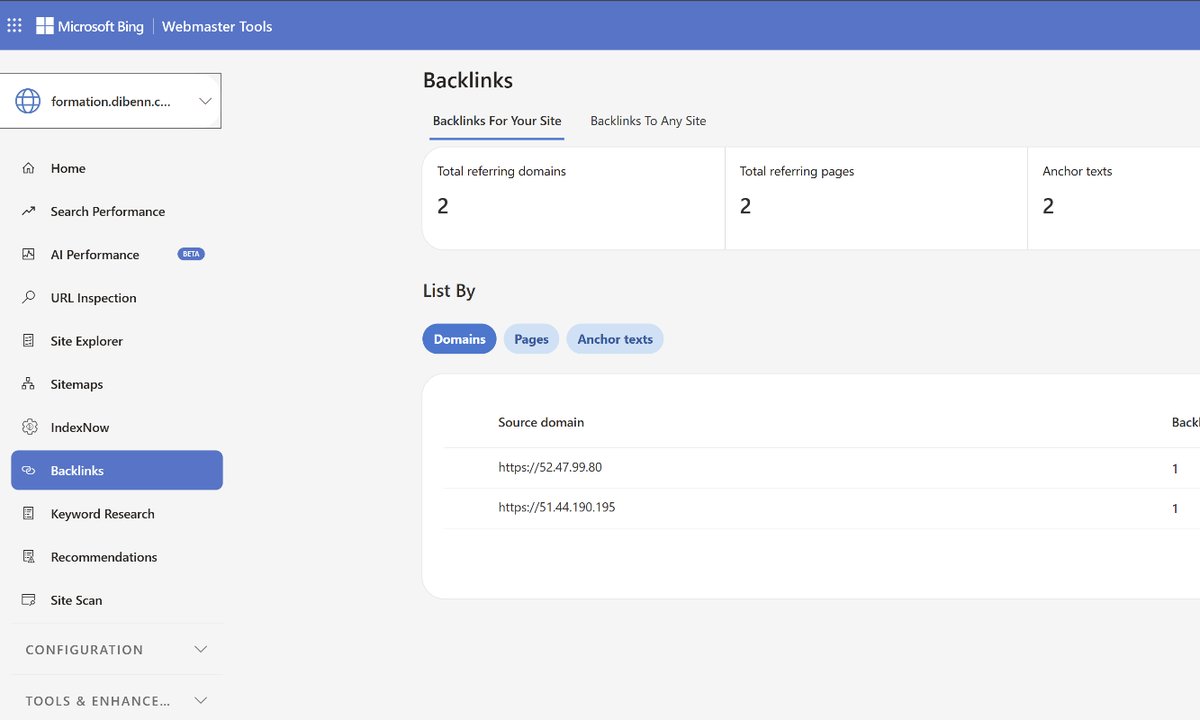
L'exemple de ce site le montre. Bing compte deux « domaines référents » qui sont en réalité des adresses IP (52.47.99.80 et 51.44.190.195), et non des noms de domaine. Ces adresses appartiennent à un hébergeur cloud et ne répondent plus. Il s'agit probablement d'un ancien hébergement du site, consulté directement par son adresse IP. Ce ne sont donc pas de vrais liens externes : c'est le site lui-même, vu sous une autre adresse.
À retenir : les chiffres de backlinks ne concordent jamais exactement d'un outil à l'autre. On les compare pour repérer des tendances et des liens inattendus, pas pour obtenir un total exact.
Ressources utiles
📌 Pour travailler sa visibilité locale
📌 Pour suivre ses liens et ses canaux
📌 Pour les sites marchands et la mesure d'audience
Exercices pratiques
Quiz
Bientôt disponible.
GEO et IA
Les internautes peuvent désormais poser une question complète, et l'IA leur répond directement. Ce chapitre explique quels contenus les moteurs de réponse citent, comment mesurer votre part de voix face aux concurrents et comment rendre une page « answer-engine ready ». L'objectif n'est plus seulement d'être classé, mais d'être cité.
Petit échauffement en image
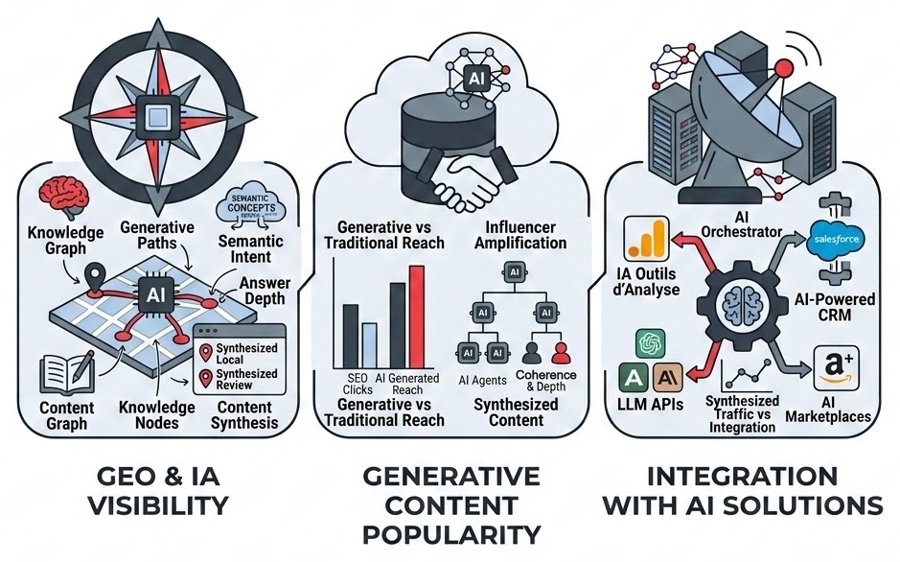
Qu'est-ce qui vous parle dans cette illustration ?
- Avez-vous déjà suivi la recommandation d'une IA pour un achat ou un choix ?
- D'où l'IA tire-t-elle, selon vous, les informations de ses réponses ?
- Comment savoir si votre marque y est citée ?
En quelques mots
Du moteur de recherche au moteur de réponse
L'internaute peut désormais poser une question complète (« quel abri de jardin en résine de 5 m² résiste au vent pour moins de 600 € ? »)[4]. L'IA synthétise et recommande directement, comme un vendeur virtuel[4].
L'IA cite du contenu qui répond, pas des catalogues
Sur les questions génériques, elle reprend surtout des guides, des comparatifs et des FAQ. Et être connu n'est pas être cité (retour d'expérience).
Recherche zéro clic et part de voix
L'internaute obtient souvent sa réponse sans cliquer[9] : on mesure donc aussi la part des réponses d'IA qui citent la marque face aux concurrents (part de voix, ou SOV). Les réponses variant d'un essai à l'autre, on cherche des tendances (retour d'expérience). Pour tester ChatGPT, activez la recherche web : sans elle, il répond de mémoire, sans citer de sources récentes (retour d'expérience).
Une page « answer-engine ready »
Elle place la réponse en tête de page (encart « En bref »), avec des paragraphes courts qui se suffisent à eux-mêmes, des termes nommés explicitement,
une FAQ balisée en FAQPage, des tableaux comparatifs. Google n'affiche plus les FAQ en résultat enrichi
depuis le 7 mai 2026[5] (elles étaient déjà réservées, depuis août 2023, aux sites gouvernementaux et de
santé reconnus[6]). Le balisage reste utile pour Bing et les IA, qui en extraient facilement les paires
question-réponse (retour d'expérience).
Ressources utiles
📌 Pour mesurer sa visibilité dans les réponses IA
📌 Pour structurer un contenu citable
- [4] Fonctionnalités d'IA et votre site web — Google
- [5] Fin des FAQ en résultat enrichi le 7 mai 2026 — Google (en anglais)
- [6] FAQ réservées aux sites gouvernementaux et de santé, août 2023 — Google (en anglais)
- [7] La proposition llms.txt
- [8] Recherche générative de Google : les bonnes pratiques (en anglais)
📌 Effet des résumés IA sur les clics
Exercices pratiques
Quiz
Bientôt disponible.
Indicateurs de performance et acquisition
On ne peut optimiser que ce que l'on peut mesurer.
Impressions, clics, taux de clic, position moyenne constituent les KPI incontournablesdu SEO "classique".
Ce chapitre vous apprend à lire les indicateurs de Search Console et de Bing Webmaster Tools, à connaître leurs limites et à
distinguer la notoriété (requêtes de marque) de la conquête (requêtes hors marque).
De quoi vérifier vous-même au fil de l'eau l'effet de chaque optimisation.
Petit échauffement en image
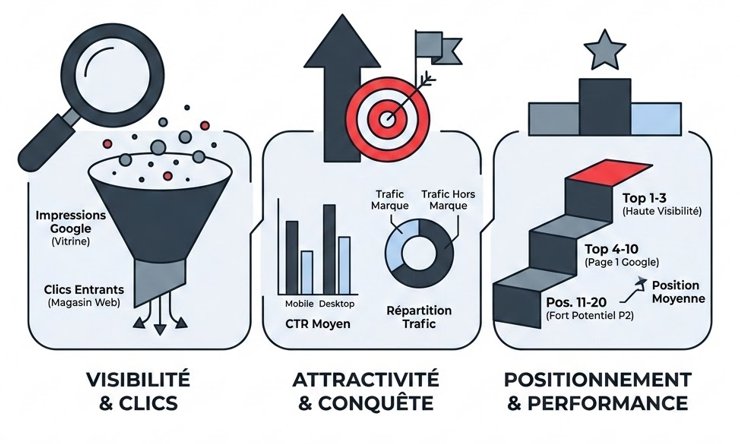
Qu'est-ce qui vous parle dans cette illustration ?
- Quelle différence faites-vous entre une impression et un clic ?
- Que vous évoque le « trafic hors marque » ? Pourquoi serait-il un levier de conquête ?
- Pourquoi les positions 11 à 20 seraient-elles un « fort potentiel » ?
En quelques mots
Impressions (SEO) et citations (GEO)
Une impression est comptée à chaque affichage d'un lien vers le site dans les résultats[2].
Si l'on reprend l'analogie d'une boutique physique, cela correspond au passage des visiteurs devant la vitrine.
En GEO, on parle de citation : la page est citée comme source dans une réponse rédigée par une IA.
- Google Search Console compte les citations dans les AI Overviews et l'AI Mode comme des
impressions[2]. Depuis le 31 août 2026, le rapport « Fonctionnalités d'IA générative » (en bêta, menu Performances › IA générative) les isole, par page, pays,
appareil et date[3][7].
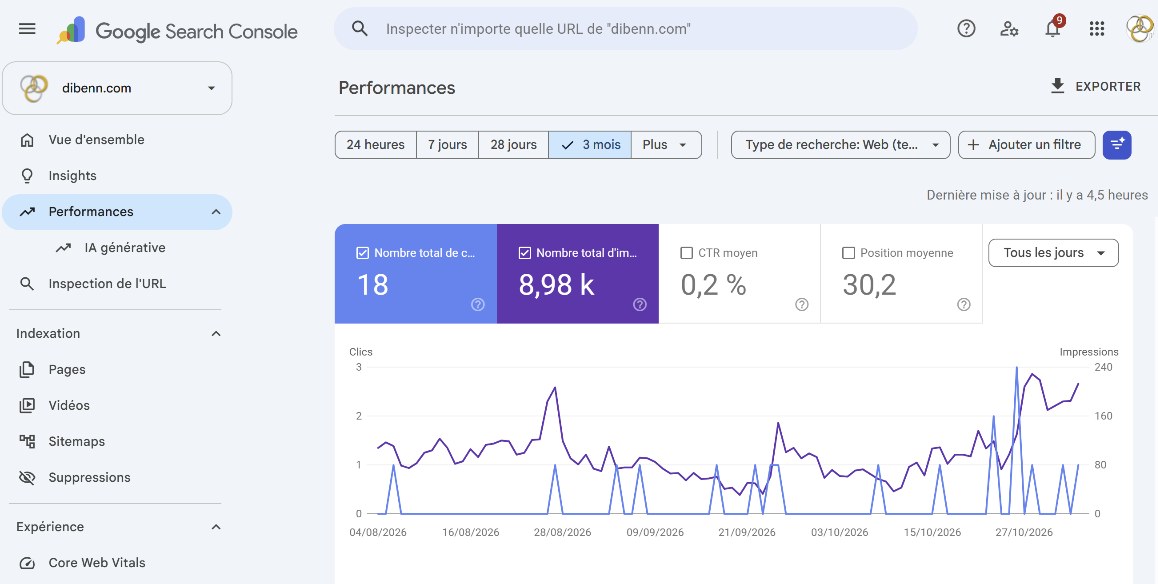 Search Console, rapport Performances : dibenn.com sur 3 mois (novembre 2026).
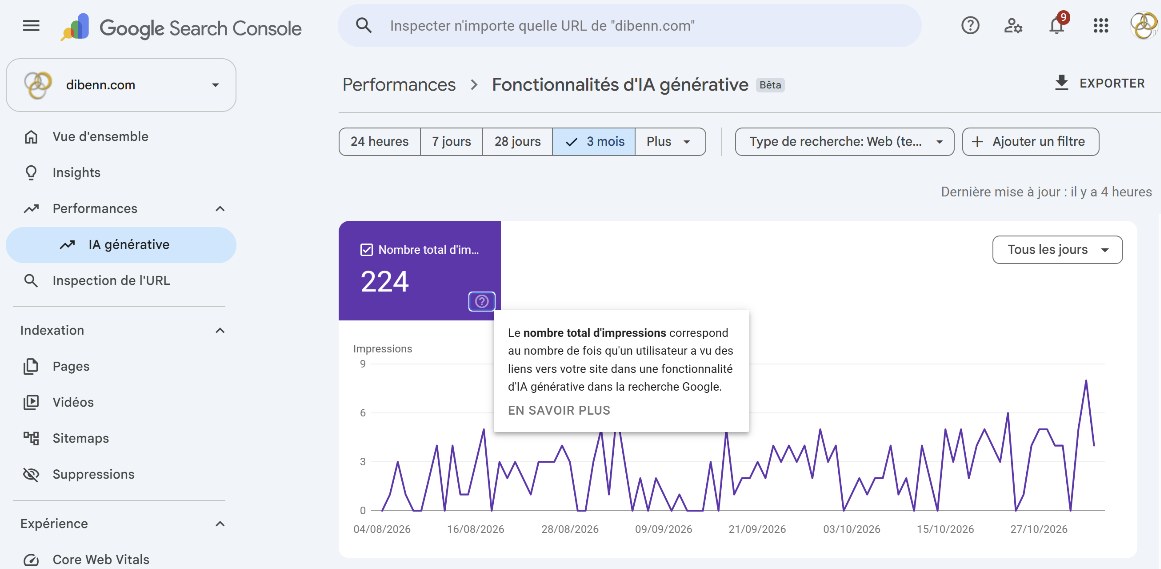 Search Console, rapport Fonctionnalités d'IA générative : dibenn.com sur 3 mois (novembre 2026).
- Bing Webmaster Tools compte, dans son rapport « AI Performance » (en préversion depuis février
2026), les citations dans Copilot, dans les résumés IA de Bing et chez certains partenaires. Il indique aussi les
pages citées et les « requêtes d'ancrage » (grounding queries) : un échantillon regroupé, et non les
questions exactes des internautes[13][14].
Son rapport Search Performance, lui, réunit depuis 2023 les impressions et les clics de la recherche web
et du chat de Bing (Copilot), sans pouvoir les séparer : le filtre s'intitule « Web and Chat »[17].
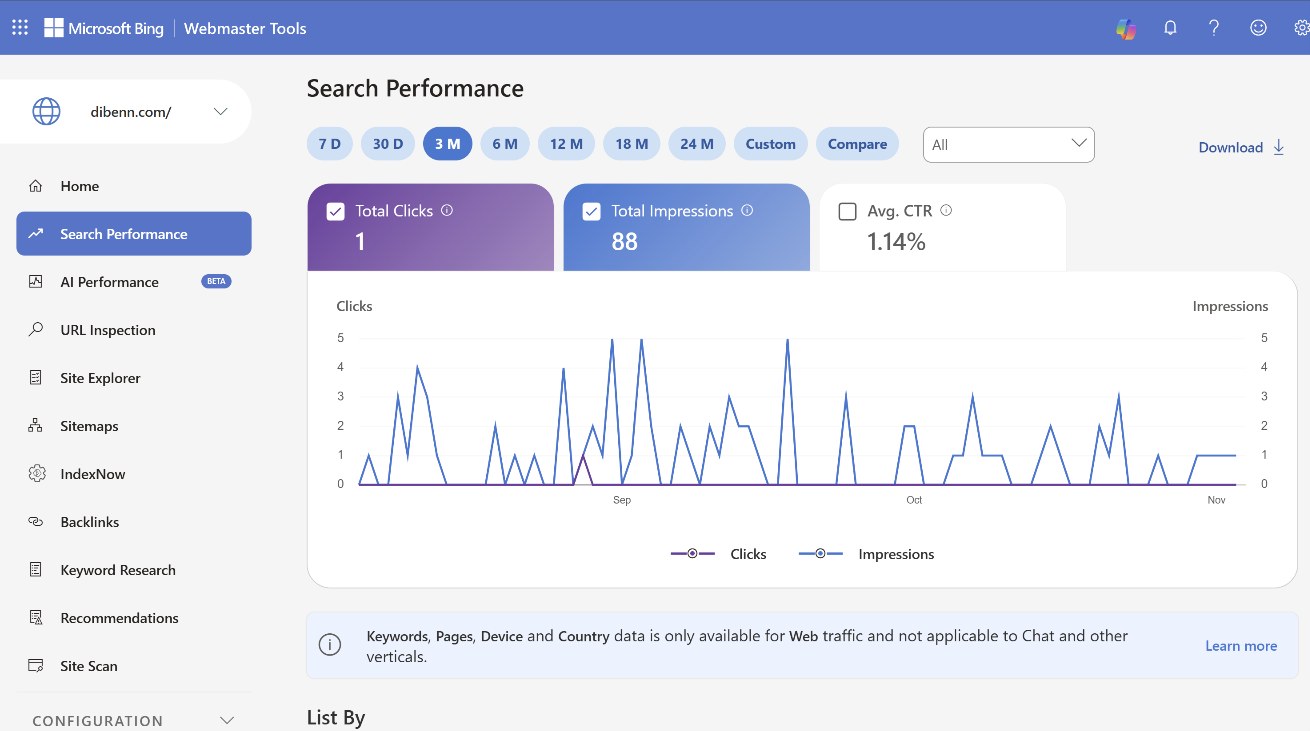 Bing Webmaster Tools, rapport Search Performance : dibenn.com sur 3 mois (novembre 2026).
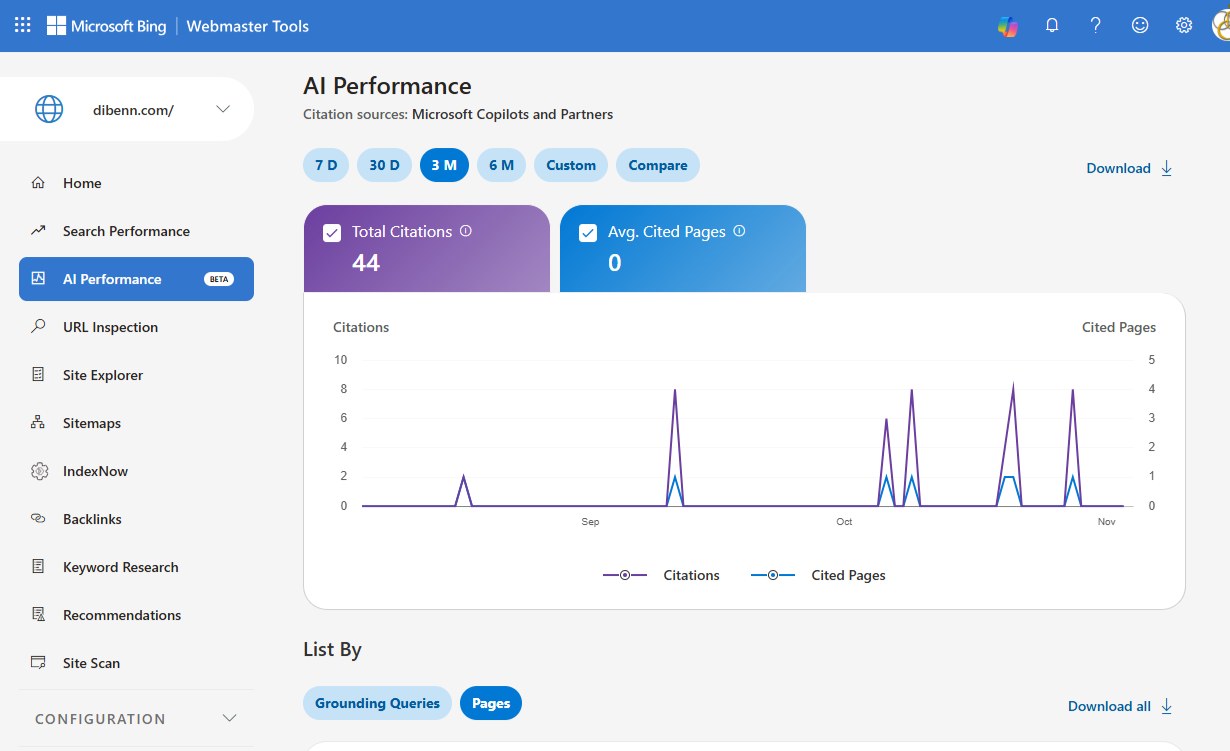 Bing Webmaster Tools, rapport AI Performance : dibenn.com sur 3 mois (novembre 2026).
Une impression ou une citation n'est pas une visite : elle montre que la page a été vue, ou utilisée par une IA.
Clics et CTR (taux de clic)
Un clic est comptabilisé à chaque clic sur l'extrait de résultat de recherche qui amène sur le site[2].
Et les clics venus de l'IA ? Chez Google, un clic sur un lien d'un AI Overview ou de l'AI Mode
compte comme un clic, dans le rapport Performances, avec les clics classiques : à ce jour, on ne peut pas les
distinguer[4]. Le rapport « Fonctionnalités d'IA générative » n'affiche que des impressions[3]. Chez Bing, le rapport
AI Performance ne fournit pas de clics[13] ; les clics venus du chat (Copilot)
sont comptés dans Search Performance avec ceux de la recherche web, sans pouvoir les distinguer[17].
Le CTR (Click Through Rate) se calcule ainsi : (clics ÷ impressions) × 100[2].
Il mesure l'attractivité de l'extrait affiché : title, meta description, étoiles (notation).
Attention, les réponses des IA (recherches « zéro clic ») le font baisser sans que la page soit moins bonne (retour d'expérience)[22].
Le trafic venu de ChatGPT
D'après le périmètre que décrit chacun, ni Search Console ni Bing Webmaster Tools ne mesurent
ChatGPT[3][13]. Selon la FAQ d'OpenAI destinée aux éditeurs, ChatGPT ajoute le paramètre
utm_source=chatgpt.com aux liens vers les sites qu'il cite[20] : ce trafic se repère donc dans
Google Analytics (source de session « chatgpt.com »). Pour être cité dans les recherches de ChatGPT, le site ne
doit pas bloquer le robot de recherche d'OpenAI, OAI-SearchBot, dans son robots.txt[20][21].
Pour Perplexity et l'application Gemini, nous n'avons pas trouvé d'indication officielle à ce jour.
La position moyenne (SEO)
Elle se lit par tranches :
1 à 3 (forte visibilité),
4 à 10 (première page),
11 à 20 (deuxième page).
Les requêtes en positions 11 à 20 sont les plus
rapides à faire progresser (retour d'expérience).
Cas particulier : un AI Overview occupe une seule position, et tous ses liens reçoivent cette même position[2].
Search Console et Bing Webmaster Tools : les deux outils incontournables
Les deux outils sont gratuits[8][19] et complémentaires. D'après le périmètre que décrit chacun, aucun ne couvre ChatGPT, Perplexity, Claude ni l'application Gemini[3][13].
| Google Search Console | Bing Webmaster Tools | |
|---|---|---|
| Couvre | Recherche Google (dont Images, Vidéos, Actualités) et Discover[1][9][10] | Recherche Bing (dont Images, Vidéos, Actualités) et chat de Bing (Copilot)[17] |
| Visibilité dans l'IA | Impressions dans les AI Overviews et l'AI Mode (pas l'application Gemini)[3] | Citations dans Copilot, les résumés IA de Bing et certains partenaires ; requêtes d'ancrage ; part de citations (en préversion)[13][15] |
| Clics depuis l'IA | Comptés, mais mélangés aux clics classiques[4] | Comptés dans Search Performance, mais mélangés aux clics web (filtre « Web and Chat »)[17] ; absents d'AI Performance[13] |
| Historique | 16 mois[6] : exportez régulièrement vos données pour garder un historique plus long | Jusqu'à 24 mois (sélecteur de dates de l'outil, novembre 2026) ; l'annonce officielle d'octobre 2024 parlait de 16 mois[18] |
| Limites | Requêtes rares anonymisées (la somme des clics par requête est donc inférieure au total, et c'est normal) ; seules les principales lignes de données sont conservées ; données disponibles sous 2 à 3 jours[5] | Rapport IA en préversion ; requêtes d'ancrage échantillonnées et regroupées[13][14] |
🔍 Bing Webmaster Tools : un site couvre aussi ses sous-domaines
Dans Search Console, on choisit entre deux types de propriété. Une propriété de domaine
(dibenn.com) regroupe tous les sous-domaines et les variantes http/https. Une propriété
préfixe d'URL se limite à une adresse précise[12]. Bing Webmaster Tools ne propose pas ce choix :
un site ajouté couvre automatiquement son adresse et tout ce qui se trouve en dessous.
Sur ce site, les adresses s'emboîtent comme des poupées russes :
dibenn.com
 └─ formation.dibenn.com
└─ preprod.formation.dibenn.com 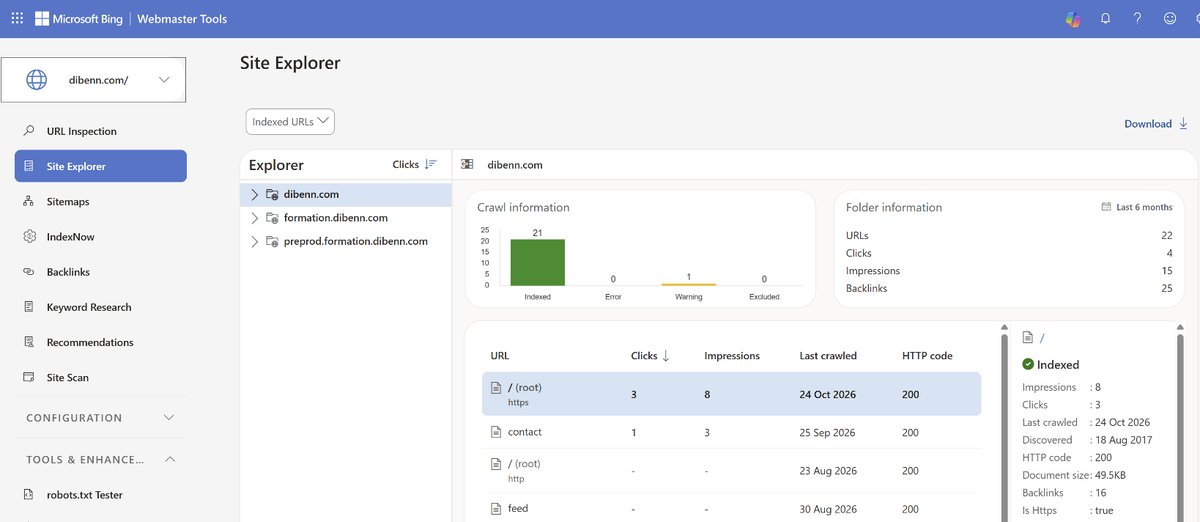
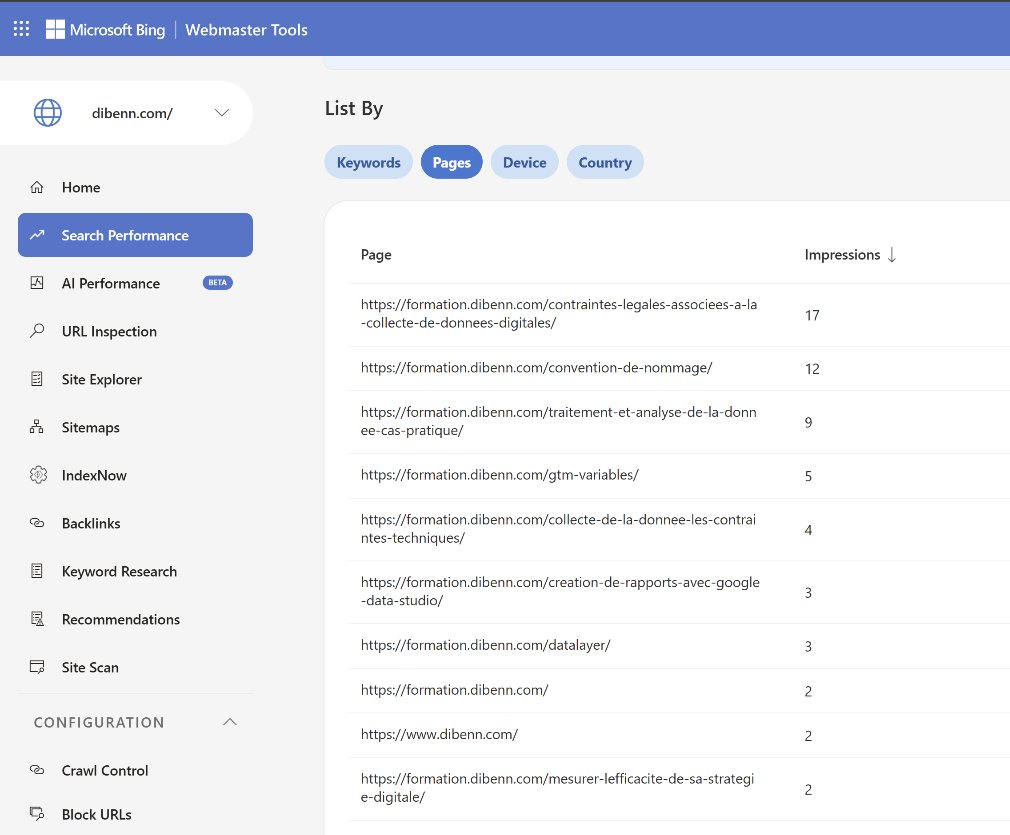
Les conséquences :
- Pour une vue d'ensemble, on consulte le site racine (
dibenn.com). Ses rapports additionnent les performances de tous les sous-domaines (www compris) et des versions http/https, comme une propriété de domaine dans Search Console. - Pour zoomer sur un sous-domaine, on l'ajoute comme site à part
(
formation.dibenn.com). Ses données apparaissent alors à deux endroits : il ne faut pas additionner les deux. - La liste déroulante en haut à gauche n'est pas une arborescence. Elle affiche seulement les sites ajoutés, chacun vérifié séparément.
- Un sous-domaine de test (une préprod) apparaît lui aussi dans les rapports. C'est une raison de plus de bien le protéger (voir le cas vécu du chapitre SEO technique et indexation).
Requêtes de marque et hors marque
Les premières contiennent le nom de l'entreprise[11] : elles mesurent la notoriété. Les secondes décrivent un besoin (« abri de jardin bois 5 m² ») : c'est là que se joue la conquête de nouveaux clients.
📖 Le saviez-vous ? La recherche "zéro clic" rebat les cartes
Avec la montée en puissance des recherches effectuées par l'IA, certains indicateurs perdent de leur pertinence, au profit d'autres KPI.
Par exemple, les clics et CTR ne sont plus aussi révélateurs d'un contenu attractif[22], tandis que les citations IA sont devenues le nouvel eldorado du référencement.
Ressources utiles
📌 Google Search Console
- [1] Rapport sur les performances — Aide Search Console
- [2] Que sont les impressions, les clics et la position ? (y compris AI Overviews et AI Mode)
- [3] Rapport sur les performances de l'IA générative (Recherche) — Aide Search Console
- [4] Fonctionnalités d'IA et votre site web — Google Search Central
- [5] À propos des données de la Search Console
- [6] Analyser une baisse du trafic de recherche (historique de 16 mois) — Google Search Central
- [7] Lancement des rapports sur l'IA générative, 3 juin 2026 (en anglais)
- [8] À propos de la Search Console, un service gratuit — Aide Search Console
- [9] Rapport sur les performances de Discover — Aide Search Console
- [10] Rapport sur les performances de Google Actualités — Aide Search Console
- [11] Filtre des requêtes de marque, novembre 2025, ouvert à tous les sites éligibles en mars 2026 (en anglais)
- [12] Ajouter une propriété : domaine ou préfixe d'URL — Aide Search Console
📌 Bing Webmaster Tools
- [13] Aide AI Performance (en anglais)
- [14] Lancement d'AI Performance en préversion, février 2026 (en anglais)
- [15] Intentions, thèmes, part de citations et comparaison, juin 2026 (en anglais)
- [16] Topics Portfolio, en bêta, octobre 2026 (en anglais)
- [17] Search Performance réunit le web et le chat, septembre 2023 (en anglais)
- [18] 16 mois de données dans Search Performance, octobre 2024 (en anglais)
- [19] Bing Webmaster Tools, un outil gratuit : présentation, juin 2025 (en anglais)
📌 ChatGPT (OpenAI)
📌 Effet des résumés IA sur les clics
📌 Anticiper et suivre la saisonnalité des recherches et requêtes
La demande varie au fil de l'année. Une page s'optimise deux à trois mois avant le pic, s'indexe le mois précédent, et capte le trafic au moment des recherches (retour d'expérience).
Comprendre quelles sont les requêtes les plus en vogue du moment permet également de répondre plus précisément à la question 'de quoi parler' évoquée au premier chapitre.
NB : Il existe une multitude d'outils pour réaliser des analyses de tendances. Ce site prend le parti de ne présenter que les outils gratuits (ou en tout cas avec une fonctionnalité gratuite) pour permettre de réaliser les exercices sans autre formalité.
📌 Construire ses tableaux de bord
Exercices pratiques
Quiz